Mise en service : les preuves attendues par l’exploitation
Publié le · Mis à jour le · À propos des dates éditoriales
Avant une mise en service, reliez chaque risque à une preuve vérifiable : service attendu, alertes, reprise, responsabilités et transfert à l’exploitation.
Décider sur ce que l’équipe saura faire demain
La recette fonctionnelle est terminée. Les utilisateurs ont validé leurs parcours et la date de démarrage approche. Pourtant, une question reste ouverte : si le service se dégrade demain matin, qui le verra, qui interviendra et avec quels moyens ?
Notre point de vue : une mise en service doit rendre l’exploitation capable d’agir, pas seulement lui transmettre des documents. Le dossier utile relie chaque engagement important à une preuve consultable et à un responsable. Il permet de distinguer ce qui a été démontré, ce qui reste à vérifier et ce qui fait l’objet d’une réserve acceptée.
La grille proposée ici accompagne la préparation du passage en service. Elle ne remplace ni les exigences du projet, ni les validations sécurité, contractuelles ou réglementaires applicables. Son niveau de détail dépend de la criticité du service et de la capacité des équipes à le rétablir.
Définir le service avant les indicateurs
Commencez par les activités que les utilisateurs doivent pouvoir réaliser. Pour une application de gestion, « le serveur répond » ne démontre pas qu’une commande peut être enregistrée. Pour un flux de données, le traitement peut être terminé alors que le résultat est trop ancien pour être utile.
Décrivez le parcours essentiel, ses horaires d’usage, ses dépendances et le comportement acceptable en mode dégradé. Précisez ensuite ce que vous observerez : réussite de l’opération, délai, fraîcheur ou autre mesure pertinente. Un objectif sans population ni fenêtre de mesure reste ambigu.
Le chapitre Implementing SLOs de Google SRE présente les objectifs de niveau de service comme un outil de décision sur la fiabilité, lié à l’expérience des utilisateurs. Notre grille transpose cette logique à une revue de mise en service : elle ne reprend pas des seuils Google et ne suppose aucun niveau de disponibilité universel.
Associez le métier, l’équipe qui construit et celle qui exploite à cette définition. Un engagement impossible à mesurer ou à tenir doit être discuté avant d’être inscrit dans un tableau de suivi.
Cinq familles de preuves à demander
Sur petit écran, faites défiler le tableau horizontalement pour lire toutes les colonnes.
| Question | Preuve proposée | Point de vigilance |
|---|---|---|
| Le service attendu fonctionne-t-il ? | Un parcours critique exécuté dans un environnement représentatif, avec résultat daté. | Documenter les écarts avec la production. |
| Verra-t-on une dégradation ? | Une alerte déclenchée lors d’un test contrôlé et reçue par l’équipe prévue. | Vérifier le destinataire et la couverture horaire. |
| Peut-on rétablir le service ? | Un exercice de reprise ou de retour arrière, avec durée observée et contrôle des données. | Une sauvegarde disponible ne prouve pas une restauration réussie. |
| Qui prend la main ? | Une chaîne de responsabilité, des accès testés et une procédure d’escalade utilisable. | Prévoir les absences et les intervenants externes. |
| L’équipe a-t-elle reçu le relais ? | Une prise en main de la procédure par l’exploitation et un traitement d’incident simulé. | Un document envoyé n’est pas une capacité démontrée. |
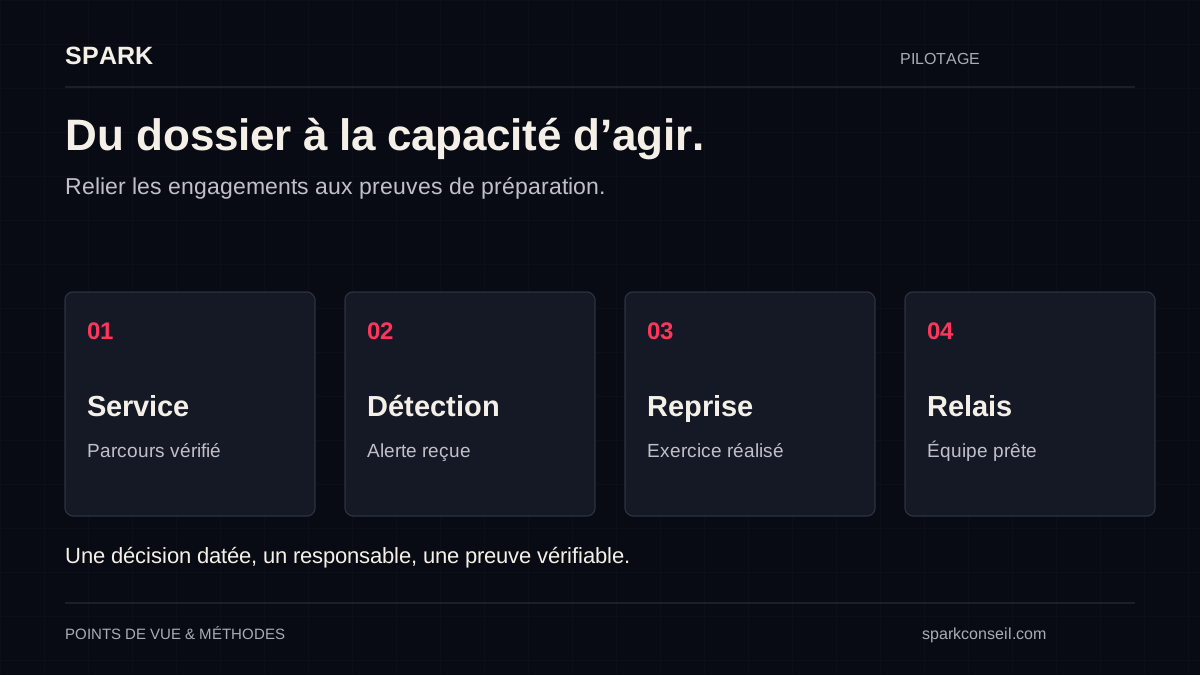
Pour chaque preuve, conservez sa date, la version du service, l’environnement, le résultat et les limites. Un changement important intervenu après le test peut imposer une nouvelle vérification. L’objectif n’est pas de remplir cinq cases vertes, mais de comprendre ce que ces cases démontrent réellement.
Faire une répétition courte avec l’exploitation
Choisissez un scénario crédible : un traitement qui ne se termine pas, une dépendance indisponible, une donnée attendue qui n’arrive pas. Dans un cadre de test maîtrisé, déroulez détection, qualification, décision et reprise. N’introduisez pas une panne en production pour satisfaire cette grille.
Laissez l’équipe d’exploitation utiliser les procédures et les accès prévus, sans que les concepteurs fassent toutes les actions à sa place. Observez où elle hésite : lien introuvable, permission absente, propriétaire non identifié, retour arrière ambigu. Ce sont des éléments précis à corriger avant le transfert.
La Production Readiness Review décrite par Google SRE fournit un repère sur la préparation d’un service à sa prise en charge. Le format doit néanmoins rester proportionné à votre contexte : une application interne et un service utilisé en continu n’ont pas les mêmes besoins.
Exemple fictif : un flux livré, un relais encore fragile
Situation illustrative, sans résultat client revendiqué. Un flux nocturne alimente une application métier. Les essais fonctionnels passent, mais l’alerte d’échec arrive seulement dans la boîte du développeur. La procédure de relance existe ; les droits de l’équipe de support n’ont pas été testés.
Le comité dispose de deux faits distincts : le traitement fonctionne dans les conditions testées ; la capacité de reprise par l’exploitation n’est pas démontrée. Il peut demander le test des accès et de l’alerte avant l’ouverture, ou envisager un démarrage limité si une organisation temporaire explicitement acceptée couvre réellement le risque.
Cette organisation doit préciser qui intervient, sur quelle plage, jusqu’à quelle date et avec quelle condition d’arrêt. « L’équipe projet restera disponible » est trop vague. Si personne n’est habilité à accepter la réserve, celle-ci reste ouverte : la proximité de la date ne constitue pas une décision.
Rendre la décision de passage lisible
Préparez une synthèse d’une page comportant le périmètre autorisé, les preuves disponibles, les écarts ouverts, les protections temporaires et la décision attendue. Référencez les résultats détaillés plutôt que de les recopier. Nommez l’autorité qui décide et les responsables de la levée des réserves.
Une réserve doit contenir une conséquence compréhensible, une échéance et une condition de retrait. Le passage peut être autorisé pour un périmètre limité sans valoir accord pour tous les usages futurs. En cas de report, notez la preuve manquante qui permettra de réexaminer la décision.
Le chef de projet organise cette convergence, rend les dépendances visibles et prépare les arbitrages. Les experts techniques produisent les preuves ; le métier et l’exploitation évaluent les conséquences dans leur domaine. Cette répartition évite de faire porter à un statut de projet une décision que personne n’a réellement prise.
Que faire avec ces résultats ?
Des preuves essentielles manquent : planifiez les vérifications ciblées et réexaminez le périmètre ou la date. Un score moyen de préparation ne compense pas une incapacité à traiter un incident critique.
Les preuves sont présentes, mais le transfert reste fragile : faites une prise en main guidée, testez les accès et vérifiez la chaîne d’escalade. La prochaine action est un exercice, pas nécessairement un document supplémentaire.
Le passage est accepté avec réserves : suivez les protections temporaires jusqu’à leur levée, avec une revue datée. Après le démarrage, comparez les observations réelles aux hypothèses de préparation et ajustez les procédures. Ne clôturez pas le transfert sur la seule réussite du premier jour.
Pour votre prochaine mise en service, rassemblez le responsable métier, le responsable technique et l’exploitation. Choisissez un parcours critique, une dégradation à détecter et une reprise à démontrer. Vous obtiendrez une liste courte de décisions et de preuves manquantes, directement utilisable pour préparer le passage.
Spark mobilise des compétences de pilotage de projets, de Cloud et d’Applications pour faire travailler ensemble les équipes de réalisation et d’exploitation. À lire aussi : relier décisions et preuves et préparer un arbitrage en comité.
Sources consultées le 17 octobre 2026. Méthode et exemples proposés par la rédaction Spark Conseil.